Disponibilité maximale
Infrastructures critiques – sans compromis
déjà de
CHF
25.00
par VM et par mois
Réduisez les temps d'arrêt
Assurez une disponibilité maximale de vos systèmes critiques pour l'entreprise, même en cas d'urgence.
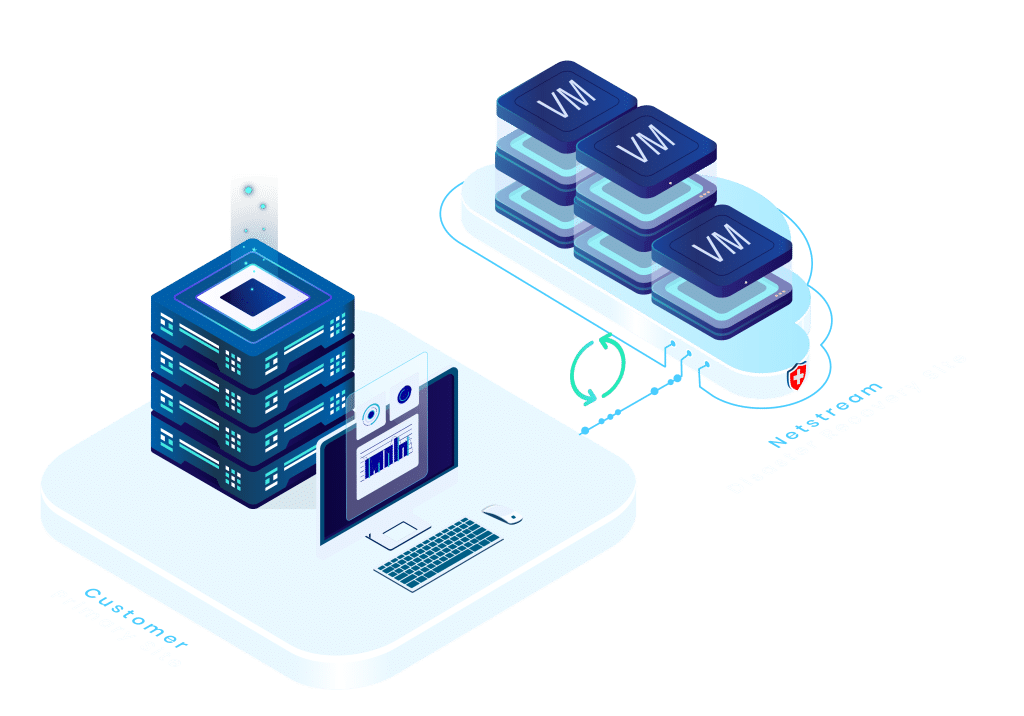
Les pannes sont inévitables, mais leur impact peut être limité. La rapidité de rétablissement des systèmes est cruciale. Le service Netstream Workload Availability garantit la réplication sécurisée de vos charges de travail et une reprise automatisée, assurant ainsi la continuité de vos processus en cas de sinistre.
Leurs systèmes critiques sont répliqués en continu dans un second centre de données, géographiquement distinct, situé en Suisse. Cela garantit la disponibilité immédiate de toutes les données et ressources en cas d'urgence, sans intervention manuelle ni perte de temps.
En cas de panne, les systèmes entiers peuvent être restaurés automatiquement, y compris les séquences de redémarrage prédéfinies et leurs dépendances. Ceci garantit un processus de redémarrage contrôlé et traçable.
Des scénarios de test réguliers vérifient vos processus de reprise d'activité, sans impacter votre environnement de production. Ces processus restent traçables, documentés et réalistes.
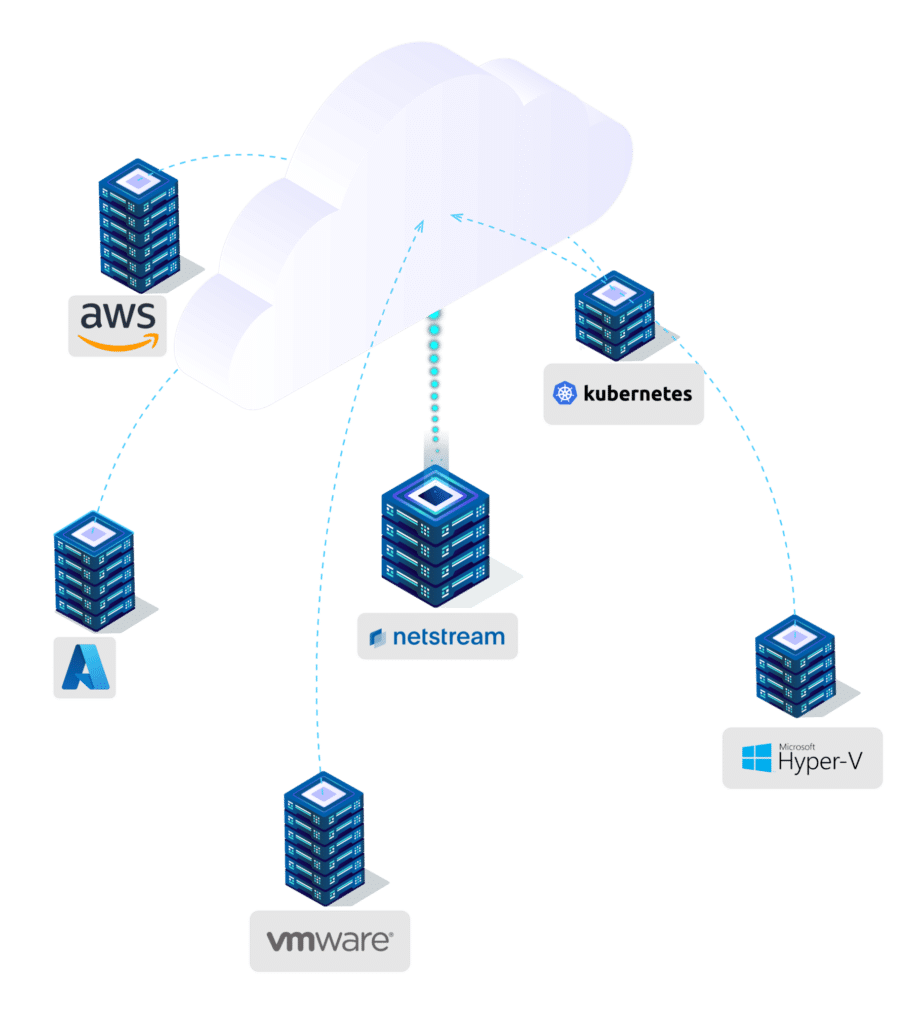
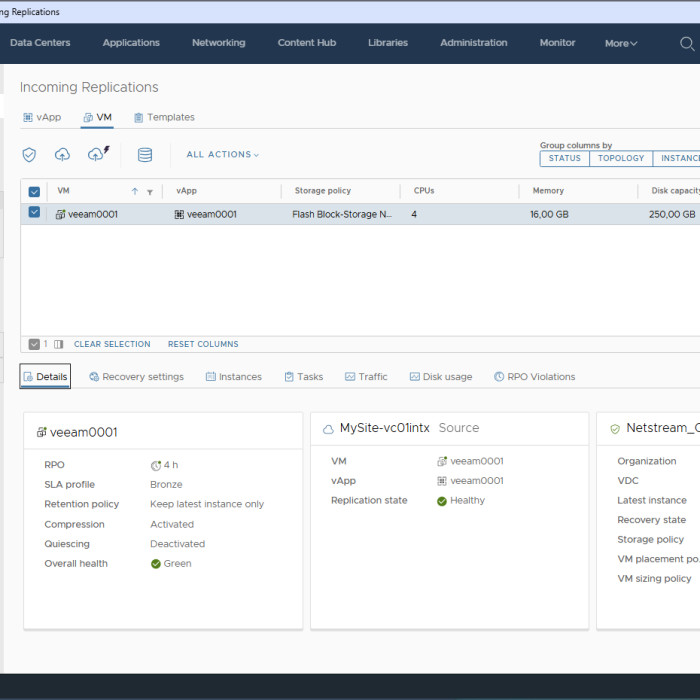
Notre solution repose sur VMware vSphere Replication et VMware Live Recovery. Elle est ainsi entièrement compatible avec les environnements VMware existants, qu'ils soient sur site ou dans le Cloud.
Toutes les données et tous les systèmes sont exploités dans nos propres centres de données en Suisse – certifiés ISO/IEC 27001, avec une alimentation électrique redondante, une énergie 100 % solaire et une sécurité maximale.
Compatible avec votre environnement VMware existant – sur site ou dans le Cloud.
Fiez-vous à des processus éprouvés – pour votre conformité et votre sécurité.
La récupération automatisée sécurise vos systèmes – rapidement et de manière fiable.
Surveillez en permanence toutes les charges de travail, les processus et les récupérations.
Effectuez des tests de récupération sans risque ni interruption des opérations.
Ne payez que ce dont vous avez réellement besoin – aucun frais caché.
En cas d’urgence, nous transférerons vos charges de travail vers notre infrastructure Cloudde manière contrôlée – y compris le réseau, les règles d’accès etag.
Selon le scénario et la configuration, la bascule peut s'effectuer en quelques minutes – avec des objectifs RTO/RPO définis.
Site Recovery automatise l'intégralité du processusagde la reprise après sinistre, de la configuration initiale à l'administration continue. Grâce à son approche basée sur des politiques et à son intégration poussée avec VMware Cloud Foundation, même les environnements de grande envergure peuvent être gérés en quelques clics.
Avec Cyber Recovery, vous stockez des instantanés dans un système de fichiersCloudVMware hautement sécurisé. Cela garantit l'intégrité de vos données même lors de la restauration, et ce, même en cas d'attaques ciblées par ransomware. De plus, les machines virtuelles sont isolées les unes des autres pendant le processus de restauration afin d'empêcher la propagation latérale de logiciels malveillants.
En cas d'urgence, chaque minute compte. Les flux de travail d'orchestration intégrés restaurent vos systèmes dans le bon ordre et selon des règles définies – rapidement, de manière fiable et sans intervention manuelle.
Vous pouvez effectuer des tests planifiés sans perturber la production. Ainsi, vous avez la certitude que votre stratégie de reprise après sinistre (PRA) fonctionnera en cas d'urgence.
En mode veille, vous ne payez qu'un forfait par machine virtuelle, auquel s'ajoute l'agde stockage requis. Les coûts supplémentaires liés à la puissance de calcul et à l'accès réseau ne surviennent qu'en cas de sinistre, lorsque votre machine virtuelle est effectivement démarrée dans le Cloud . Votre stratégie de reprise après sinistre reste ainsi rentable, sans frais initiaux inutiles.
En mode actif, les ressources de la machine virtuelle deviennent également un facteur important.
Reprise après sinistre
Bien plus qu'une simple Backup: préparez-vous spécifiquement aux pannes.
La reprise après sinistre protège non seulement vos données, mais assure également la continuité de votre activité en cas d'urgence. Contrairement aux solutions Backuptraditionnelles, Netstream permet la restauration orchestrée de systèmes entiers : entièrement automatisée, dans le bon ordre et sans intervention manuelle.
Migration facile
Transférez vos charges de travail productives de manière sûre et prévisible, sans interruption d'activité.
Utilisez le service de disponibilité des charges de travail pour vos migrations planifiées vers le CloudNetstream . Vos systèmes existants sont répliqués et testés en temps réel. Une fois la configuration terminée, la bascule est maîtrisée, sans perte de données ni interruption de production.
Téléchargez gratuitement le livre blanc
Cinq étapes pour une stratégie de reprise après sinistre
Apprenez à élaborer une stratégie moderne de reprise après sinistre – expliquée clairement, de manière pratique et adaptée à votre réalité informatique.
✔︎ Guide en 5 étapes
✔︎ Avec exemples, listes de contrôle et recommandations
✔︎ Pour les responsables informatiques, les PME et les décideurs
✔︎ Modèle à remplir supplémentaire disponible en téléchargement
Exemples de prix
Quel est le coût de la disponibilité de la charge de travail ?
- Confiance
- agenceag
- Développement logiciel
Société fiduciaire de 10 employés avec un flux de travail numérisé sur Abacus.
Un court-circuit a paralysé le serveur de l'entreprise. L'accès aux données comptables, à la paie et au système CRM est bloqué. La dernière Backup date de la veille au soir.
Configuration du serveur
-
7 machines virtuelles
-
38 vCPU
-
140 Go de RAM
-
Volume de données de 3,5 To
-
100 Go de modifications quotidiennes
sans reprise après sinistre
Durant la période de rétablissement, aucun dossier ne peut être traité et la facturation et les paiements sont retardés. L'accès aux documents est interrompu et les communications par courriel sont restreintes.
- Perte de productivité : 3 joursag10 employés × 800 CHF = 24 000 CHF
- Intervention d'urgence informatique et récupération de données = CHF 5 000
- Échéances fiscales non respectées = 12 000 CHF
- Atteinte à la réputation et perte de confiance
avec reprise après sinistre
Les sept machines virtuelles sont critiques et sont répliquées régulièrement sur le Cloud Netstream lorsqu'elles sont en veille. Le client démarre les serveurs nécessaires dans le Cloud en quelques minutes et peut ainsi poursuivre son activité. Les machines virtuelles du Cloud Netstream restent actives jusqu'à la résolution complète du problème.
agde publicité de 30 employés avec une infrastructure de bureau virtualisée.
Une panne du contrôleur RAID du nœud GPU a entraîné la défaillance des machines virtuelles de bureau à distance et du de gestion des ressources numériquesagDAM). Les autres systèmes ont continué de fonctionner, mais l'accès aux données créatives, aux plans centraux et aux environnements de production a été fortement restreint.
Configuration du serveur
-
12 machines virtuelles
-
86 vCPU
-
340 Go de RAM
-
Volume de données de 15 To
-
600 Go de modifications quotidiennes
sans reprise après sinistre
Les employés peuvent partiellement travailler sur des postes locaux, mais ils n'ont pas accès aux données centrales et leur capacité à poursuivre leur travail est limitée. La communication avec les clients est retardée et les approbations et les présentations commerciales sont reportées.
- Perte de productivité : 3 joursag30 employés × 700 CHF × 60 % = 37 800 CHF
- Pièce détachée et technicien pour la réparation du contrôleur RAID = CHF 5,000
- Retards de projet, atteinte à la réputation et réactions des clients = 10 000 CHF
avec reprise après sinistre
Les 8 machines virtuelles les plus critiques (RDS, DAM, serveurs de fichiers et de bases de données) sont répliquées sur le Cloud Netstream via un plan de reprise d'activité et peuvent être activées en quelques minutes. Pendant leur activation, ces machines virtuelles nécessitent des ressources Cloud standard.
Société de développement logiciel de clusters, de conteneurs, de bases de données et de messagerieag.
Une mise à jour progressive automatisée des nœuds Kubernetes échoue. Cela provoque une erreur de configuration dans le cluster, l'ensemble de l'écosystème de microservices .
Configuration du serveur
-
90 machines virtuelles
-
1016 vCPU
-
4656 Go de RAM
-
Volume de données de 20 To
-
2,5 To de changements quotidiens
sans reprise après sinistre
Les portails clients, les API, les applications internes et l'accès aux systèmes de production sont interrompus pendant troisag. Le support et le développement sont également fortement limités, car le CRM, l'intégration continue et la livraison continue (CI/CD) ainsi que la supervision sont indisponibles.
- Perte de productivité : 3ag× 60 employés × 750 CHF × 70 % = 94 500 CHF
- Impact sur les clients, violations des SLA, indisponibilité de l'API = 20 000 CHF
- Coût de la restauration, y compris les spécialistes externes = 10 000 CHF
avec reprise après sinistre
Les 42 systèmes critiques – notamment les nœuds Kubernetes, les microservices, les bases de données, les passerelles API, le CRM, les portails clients et l'intégration continue/déploiement continu (CI/CD) – sont répliqués en continu sur le Cloud Netstream en mode veille. En cas d'urgence, ils peuvent être activés très rapidement.
Migration à froid indépendante de la plateforme vers le Cloud
Les raisons de migrer vers le Cloud sont diverses : hausse des coûts d’exploitation, nouvelles exigences de sécurité ou plus grande flexibilité. Dans les environnements système complexes, uneagplanifiée et maîtrisée est essentielle. Les entreprises qui migrent leurs systèmes….
Scénario de migration sans interruption d'activité
De nombreuses entreprises commencent par une sauvegarde de leurs données, puis exploitent leurs systèmes de manière productive dans le Cloud. Cela permet une migration progressive, contrôlée, sécurisée et sans effort inutile.
Évaluation de la criticité : laagde votre stratégie de reprise après sinistre
Évaluez systématiquement la criticité de vos systèmes informatiques, au lieu de vous fier à votre intuition. Nous vous présenterons une méthode simple et éprouvée qui vous garantira des évaluations toujours réussies. Si….
Changement de licence VMware en 2025 : Broadcom relève les exigences minimales
Depuis le rachat de VMware par Broadcom, les changements se sont succédé. Nombre d'entreprises se montrent peu enthousiastes face à cette situation, notamment les petites structures informatiques et les fournisseurs de services.
Modèles de financement hybrides pour le Cloud: CAPEX vs. OPEX
Dans le paysage informatique actuel, en constante évolution, les entreprises doivent relever le défi de financer efficacement leurs ressources Cloud. Traditionnellement, elles privilégient l'infrastructure sur site en raison des dépenses d'investissement (CAPEX) et….
L'erreur humaine comme cause de perturbations informatiques
Les pannes matérielles, les problèmes logiciels et les rançongiciels sont des causes bien connues de perturbations et d'interruptions de service en informatique. Cependant, l'erreur humaine est également inévitable dans les services informatiques et….
Haute disponibilité pour les bases de données critiques pour l'entreprise
agjours, rares sont les entreprises qui peuvent fonctionner sans bases de données. Un sinistre ou une erreur logique affectant leur disponibilité peut entraîner une perte de données et une baisse de productivité.
Comment créer un plan de reprise après sinistre (PRA)
Un plan de reprise après sinistre (PRA) est un processus essentiel pour toute entreprise ou organisation afin de garantir que, en cas de panne ou d'interruption de l'infrastructure informatique ou d'autres systèmes critiques pour l'activité...


